OpenAI sprawdziło, jak modele AI radzą sobie z analizą prawdziwych danych pochodzących z eksperymentów biologicznych. BioBasicsBench nie składa się z przygotowanych wcześniej wykresów i prostych pytań. Modele dostają zdjęcia mikroskopowe, płytki z koloniami, wyniki sekwencjonowania, pomiary aparatury i dokumentację, w której mogą pojawić się również błędy.
Najlepszy wynik uzyskał GPT-6 Astra. Przy najwyższym poziomie rozumowania model zdobył średnio 66,7 proc. maksymalnej liczby punktów możliwych do uzyskania w 100 zadaniach BioBasicsBench. To wyraźny postęp względem wcześniejszych modeli OpenAI, ale nadal wynik daleki od bezbłędnej pracy laboratoryjnej.
Najważniejsze informacje w skrócie:
- BioBasicsBench obejmuje 100 zadań opartych na prawdziwych eksperymentach,
- benchmark powstał we współpracy OpenAI z firmą biotechnologiczną Ligo,
- GPT-6 Astra uzyskał 66,7 proc. możliwych punktów,
- GPT-6.1 Sol osiągnął 62 proc.,
- GPT-5.6 Sol zdobył 43,8 proc.,
- przetestowano siedem modeli i 37 konfiguracji,
- łącznie zebrano 18 500 odpowiedzi,
- największym problemem nadal pozostaje interpretacja obrazów, kontroli i kontekstu eksperymentu.
GPT-6 Astra zdobył 66,7 proc. możliwych punktów w BioBasicsBench
OpenAI przetestowało siedem modeli przy różnych poziomach rozumowania. Każdy z 100 problemów został rozwiązany pięć razy dla każdej konfiguracji, co dało łącznie 18 500 wyników. Ocena nie oznacza procentu poprawnie rozwiązanych zadań. Każde z nich miało własne kryteria punktowe, a końcowy wynik pokazuje średni odsetek wszystkich punktów możliwych do zdobycia.
Przy ustawieniu xhigh GPT-6 Astra uzyskał 66,7 proc. GPT-6.1 Sol osiągnął 62 proc., natomiast GPT-5.6 Sol zdobył 43,8 proc. Co ciekawe, Astra potrzebował przy tym średnio mniej tokenów na zadanie niż starszy Sol. OpenAI wiąże część poprawy z lepszymi możliwościami multimodalnymi, czyli analizą zdjęć, nagrań i surowych wyników eksperymentów.
Różnicę między generacjami modeli widać również w innych zastosowaniach naukowych. W naszym materiale o modelach GPT-6 opisujemy, jak OpenAI coraz mocniej rozwija je pod zadania wymagające analizy, pracy z narzędziami i długiego rozumowania.
Benchmark wykorzystuje zdjęcia, sekwencje DNA i prawdziwe błędy z laboratorium
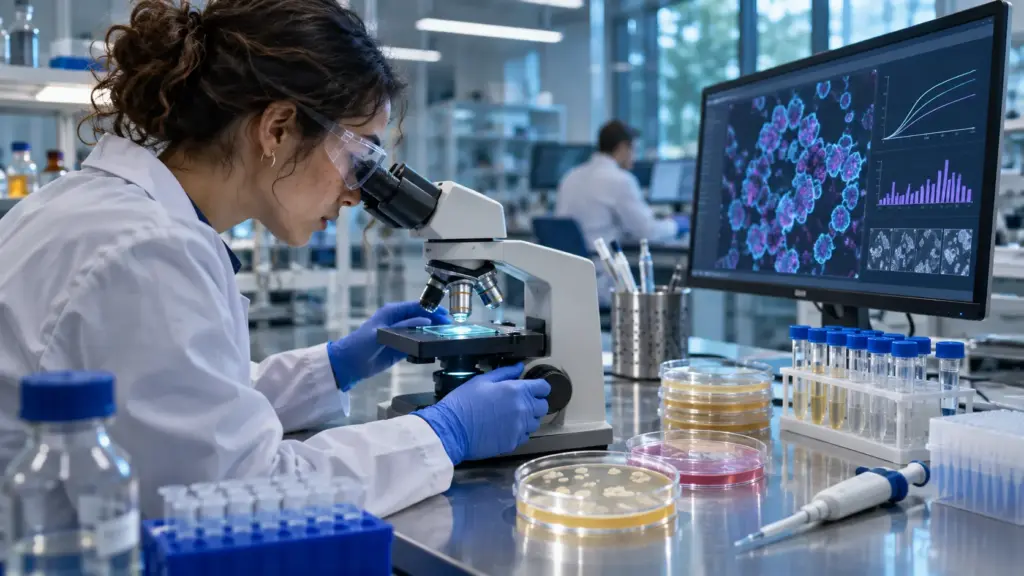
BioBasicsBench został zaprojektowany inaczej niż typowe testy naukowe dla modeli AI. Zadania powstały na podstawie rzeczywistych eksperymentów prowadzonych przez naukowców. Modele analizują między innymi obrazy mikroskopowe, żele DNA, płytki z koloniami bakterii, wyniki cytometrii, odczyty aparatury, surowe pliki sekwencjonowania oraz nagrania pokazujące wykonywanie procedur laboratoryjnych.
Dane nie zostały przy tym wyczyszczone z całego bałaganu obecnego w codziennej pracy. Na zdjęciu może pojawić się źle opisana próbka, kontrola może zostać wykonana niewłaściwie, a wynik może nie wystarczać do potwierdzenia hipotezy. Model musi więc nie tylko coś rozpoznać, ale również ocenić, czy dostępne informacje rzeczywiście pozwalają wyciągnąć określony wniosek.
To dobrze pokazuje różnicę między wiedzą biologiczną a praktyczną analizą eksperymentu. Podobne wyzwania pojawiają się szerzej przy wykorzystaniu sztucznej inteligencji w medycynie, gdzie sama znajomość wzorców nie wystarcza, jeśli system źle interpretuje jakość albo kontekst danych wejściowych.
Astra lepiej rozpoznaje błędy eksperymentu, ale nadal potrafi wybrać złą odpowiedź
Jedną z największych przewag GPT-6 Astra nad starszymi modelami była dokładniejsza analiza materiałów wizualnych. W jednym z zadań model dostał zdjęcie płytki kontrolnej z eksperymentu dotyczącego klonowania DNA. GPT-5.6 Sol potraktował ją jako prawidłową kontrolę. Astra zauważył na oznaczeniu, że użyto innego antybiotyku niż w pozostałej części doświadczenia i odrzucił wynik jako niewiarygodny.
W innym zadaniu seria zdjęć mikroskopowych pokazywała komórki pojawiające się i znikające z obrazu. Starszy model próbował znaleźć biologiczne wyjaśnienie tego zjawiska. Astra prawidłowo rozpoznał, że jest to z-stack, czyli seria zdjęć wykonywanych na różnych głębokościach próbki. Model lepiej radził sobie też z sytuacjami, w których dwa sygnały fluorescencyjne mogły się wzajemnie zakłócać.
Nie oznacza to jednak niezawodności. Astra potrafił poprawnie przeanalizować dane PCR, a następnie źle przypisać znaczenie dwóm grupom wyników i wskazać niewłaściwe próbki do dalszego etapu eksperymentu. W prawdziwym laboratorium taki błąd kosztowałby czas i materiały.
AI nadal myli artefakt obrazu z wynikiem biologicznym
Problemy widać również przy zadaniach pozornie znacznie prostszych. W jednym z testów model miał policzyć kolonie bakterii widoczne na płytce. Astra nie zawsze prawidłowo rozdzielał kolonie leżące blisko siebie, część pomijał, a fragmenty podłoża potrafił uznać za obiekty biologiczne. Końcowy wynik był zawyżony o około 12 proc.
Takie błędy mają znaczenie, ponieważ dane laboratoryjne rzadko są celem samym w sobie. Liczba kolonii może później posłużyć do obliczeń skuteczności transformacji, porównania wariantów eksperymentu albo decyzji, którą próbkę wykorzystać dalej. Niewielki błąd na początku może więc wpłynąć na kolejne etapy pracy.
BioBasicsBench pokazuje przede wszystkim, gdzie AI może być dziś użyteczne. Model może pomóc w przeglądaniu dużej liczby danych, szukaniu niespójności i przygotowaniu pierwszej analizy. 66,7 proc. możliwych punktów oznacza jednak również, że do wyniku idealnego nadal brakuje ponad jednej trzeciej. Przy pracy biologicznej to wystarczająco dużo, żeby nad interpretacją wyników nadal musiał czuwać doświadczony naukowiec.
Źródło: OpenAI. Opracowanie własne.
Dziękujemy za przeczytanie artykułu na Techoteka.pl.
Codziennie publikujemy najważniejsze informacje z Polski i ze świata dotyczące technologii, sztucznej inteligencji, nowych rozwiązań cyfrowych oraz trendów technologicznych, które kształtują przyszłość.
Obserwuj nas na Facebooku, aby być na bieżąco z najważniejszymi wydarzeniami ze świata technologii.