Google rozbudowuje ósmą generację swoich akceleratorów AI o dwa nowe systemy: TPU 8tx i TPU 8i Max. Pierwszy został przygotowany dla firm i instytucji pracujących na poufnych danych, drugi ma poradzić sobie z coraz większym zapotrzebowaniem modeli i agentów AI na pamięć oraz moc obliczeniową.
Nie są to jednak dwie całkowicie nowe architektury procesorów. Google wykorzystuje istniejące układy TPU ósmej generacji i buduje wokół nich nowe konfiguracje sprzętu, pamięci, sieci i zabezpieczeń. Dzięki temu firma może szybciej dostosowywać infrastrukturę do konkretnych zastosowań AI bez projektowania kolejnego chipu od podstaw.
Najważniejsze informacje w skrócie:
- Google zaprezentowało systemy TPU 8tx i TPU 8i Max,
- oba należą do ósmej generacji TPU,
- TPU 8tx został przygotowany do pracy z poufnymi danymi i modelami,
- system wykorzystuje procesory AMD EPYC piątej generacji,
- dane mają pozostawać chronione również podczas przetwarzania,
- TPU 8tx oferuje do dwukrotnie niższe opóźnienia niż TPU 8t,
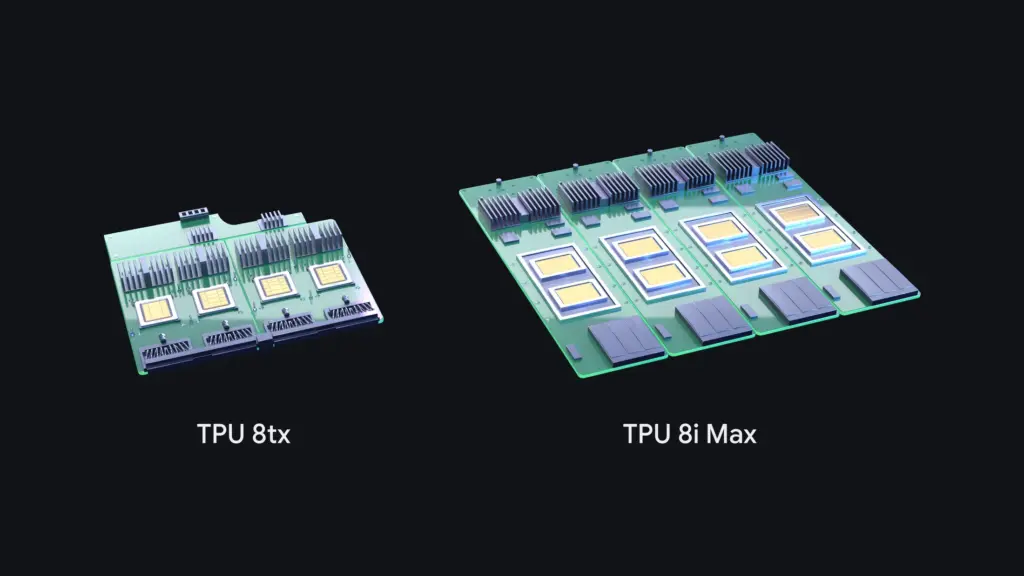
- TPU 8i Max łączy dwa układy TPU 8i w jednym module,
- zapewnia dwukrotnie większą moc obliczeniową, SRAM i przepustowość HBM niż pojedynczy TPU 8i,
- nowe rozwiązania są projektowane przede wszystkim pod duże modele i systemy agentowe.
TPU 8tx ma chronić dane nawet podczas wykonywania obliczeń AI
TPU 8tx powstał z myślą o firmach, administracji i organizacjach wykorzystujących modele AI razem z danymi, których nie mogą swobodnie przenosić pomiędzy środowiskami. W tradycyjnym systemie informacje mogą być zaszyfrowane podczas przechowywania i przesyłania, ale w czasie wykonywania obliczeń muszą zostać odszyfrowane w pamięci. To właśnie ten etap Google chce dodatkowo zabezpieczyć.
System korzysta z tego samego krzemu co TPU 8t, ale został połączony z procesorami AMD EPYC piątej generacji. Mechanizmy sprzętowe mają izolować dane i parametry modelu również podczas aktywnego przetwarzania. TPU 8tx może dzięki temu służyć do inferencji, dostrajania modeli na prywatnych zbiorach danych oraz uczenia agentów metodami reinforcement learning bez konieczności przenoszenia informacji do oddzielnego klastra.
Google podaje również, że wykorzystanie sieci Boardfly pozwala uzyskać nawet dwukrotnie niższe opóźnienia niż w TPU 8t przy minimalnym wpływie dodatkowych zabezpieczeń na wydajność. Ma to znaczenie szczególnie przy agentach AI, które wykonują wiele kolejnych operacji i częściej korzystają z firmowych danych oraz zewnętrznych narzędzi.
TPU 8i Max podwaja moc, SRAM i przepustowość pamięci HBM
Drugi z nowych systemów rozwiązuje zupełnie inny problem. W największych modelach AI ograniczeniem coraz częściej przestaje być sama liczba operacji wykonywanych przez procesor. Wąskim gardłem staje się pamięć i szybkość, z jaką dane można dostarczyć do układów obliczeniowych.
Google połączyło dlatego dwa układy TPU 8i w jednym module. TPU 8i Max zapewnia w porównaniu z pojedynczym 8i dwukrotnie większą moc obliczeniową, dwukrotnie więcej pamięci SRAM oraz dwukrotnie większą przepustowość HBM. Jednocześnie system mieści dwa razy więcej krzemu w tej samej przestrzeni szafy serwerowej, co pozwala zwiększyć gęstość obliczeń bez proporcjonalnego powiększania centrum danych.
Taka konstrukcja jest skierowana przede wszystkim do modeli pracujących na bardzo długim kontekście. Google wskazuje scenariusze, w których wiele agentów jednocześnie analizuje całe repozytorium kodu albo wiele godzin materiału wideo. Przy takich obciążeniach pamięć musi nadążać za samymi jednostkami obliczeniowymi, inaczej kosztowny akcelerator część czasu spędza na oczekiwaniu na dane.
Rosnący kontekst jest już jednym z głównych kierunków rozwoju modeli takich jak Google Gemini. TPU 8i Max pokazuje, że walka o długość kontekstu przenosi się również bezpośrednio na poziom infrastruktury.
Google nie projektuje nowego procesora za każdym razem. Zmienia cały system wokół TPU
Google mocno podkreśla różnicę pomiędzy nowym chipem a nowym systemem. Zaprojektowanie układu scalonego wymaga wieloletniego procesu i przygotowania nowej architektury fizycznej. TPU 8tx oraz TPU 8i Max wykorzystują natomiast istniejące elementy ósmej generacji, które firma łączy z innymi procesorami, pamięcią, siecią i mechanizmami bezpieczeństwa.
Takie podejście pozwala Google szybciej reagować na zmiany zachodzące w AI. TPU 8t jest nastawiony przede wszystkim na trenowanie dużych modeli, TPU 8i na szybkie wnioskowanie, 8tx na poufne obliczenia, a 8i Max na zadania wymagające bardzo dużej pamięci i długiego kontekstu. Po raz pierwszy Google wprowadziło w jednym roku aż cztery systemy należące do tej samej generacji TPU.
Firma jednocześnie próbuje ograniczyć jedną ze swoich największych słabości wobec GPU Nvidii: dostępność oprogramowania. Google otworzyło TorchTPU, dzięki czemu kod PyTorch i modele Hugging Face mogą być uruchamiane na TPU bez przepisywania całych aplikacji. Powstają również narzędzia automatyzujące optymalizację kodu i zarządzanie dużymi klastrami.
TPU przestaje więc być sprzętem rozwijanym głównie na potrzeby Google i Gemini. Firma coraz wyraźniej buduje z niego osobną platformę infrastrukturalną dla zewnętrznych klientów. TPU 8tx i 8i Max pokazują przy tym, że konkurencja z Nvidią będzie coraz częściej dotyczyć nie tylko wydajności samego procesora, lecz całego systemu: pamięci, sieci, bezpieczeństwa i oprogramowania.
Źródła: Google Cloud, AMD. Opracowanie własne.
Dziękujemy za przeczytanie artykułu na Techoteka.pl.
Codziennie publikujemy najważniejsze informacje z Polski i ze świata dotyczące technologii, sztucznej inteligencji, nowych rozwiązań cyfrowych oraz trendów technologicznych, które kształtują przyszłość.
Obserwuj nas na Facebooku, aby być na bieżąco z najważniejszymi wydarzeniami ze świata technologii.